

Mismo caso de uso, resultados comparables y una diferencia de consumo que merece contexto.
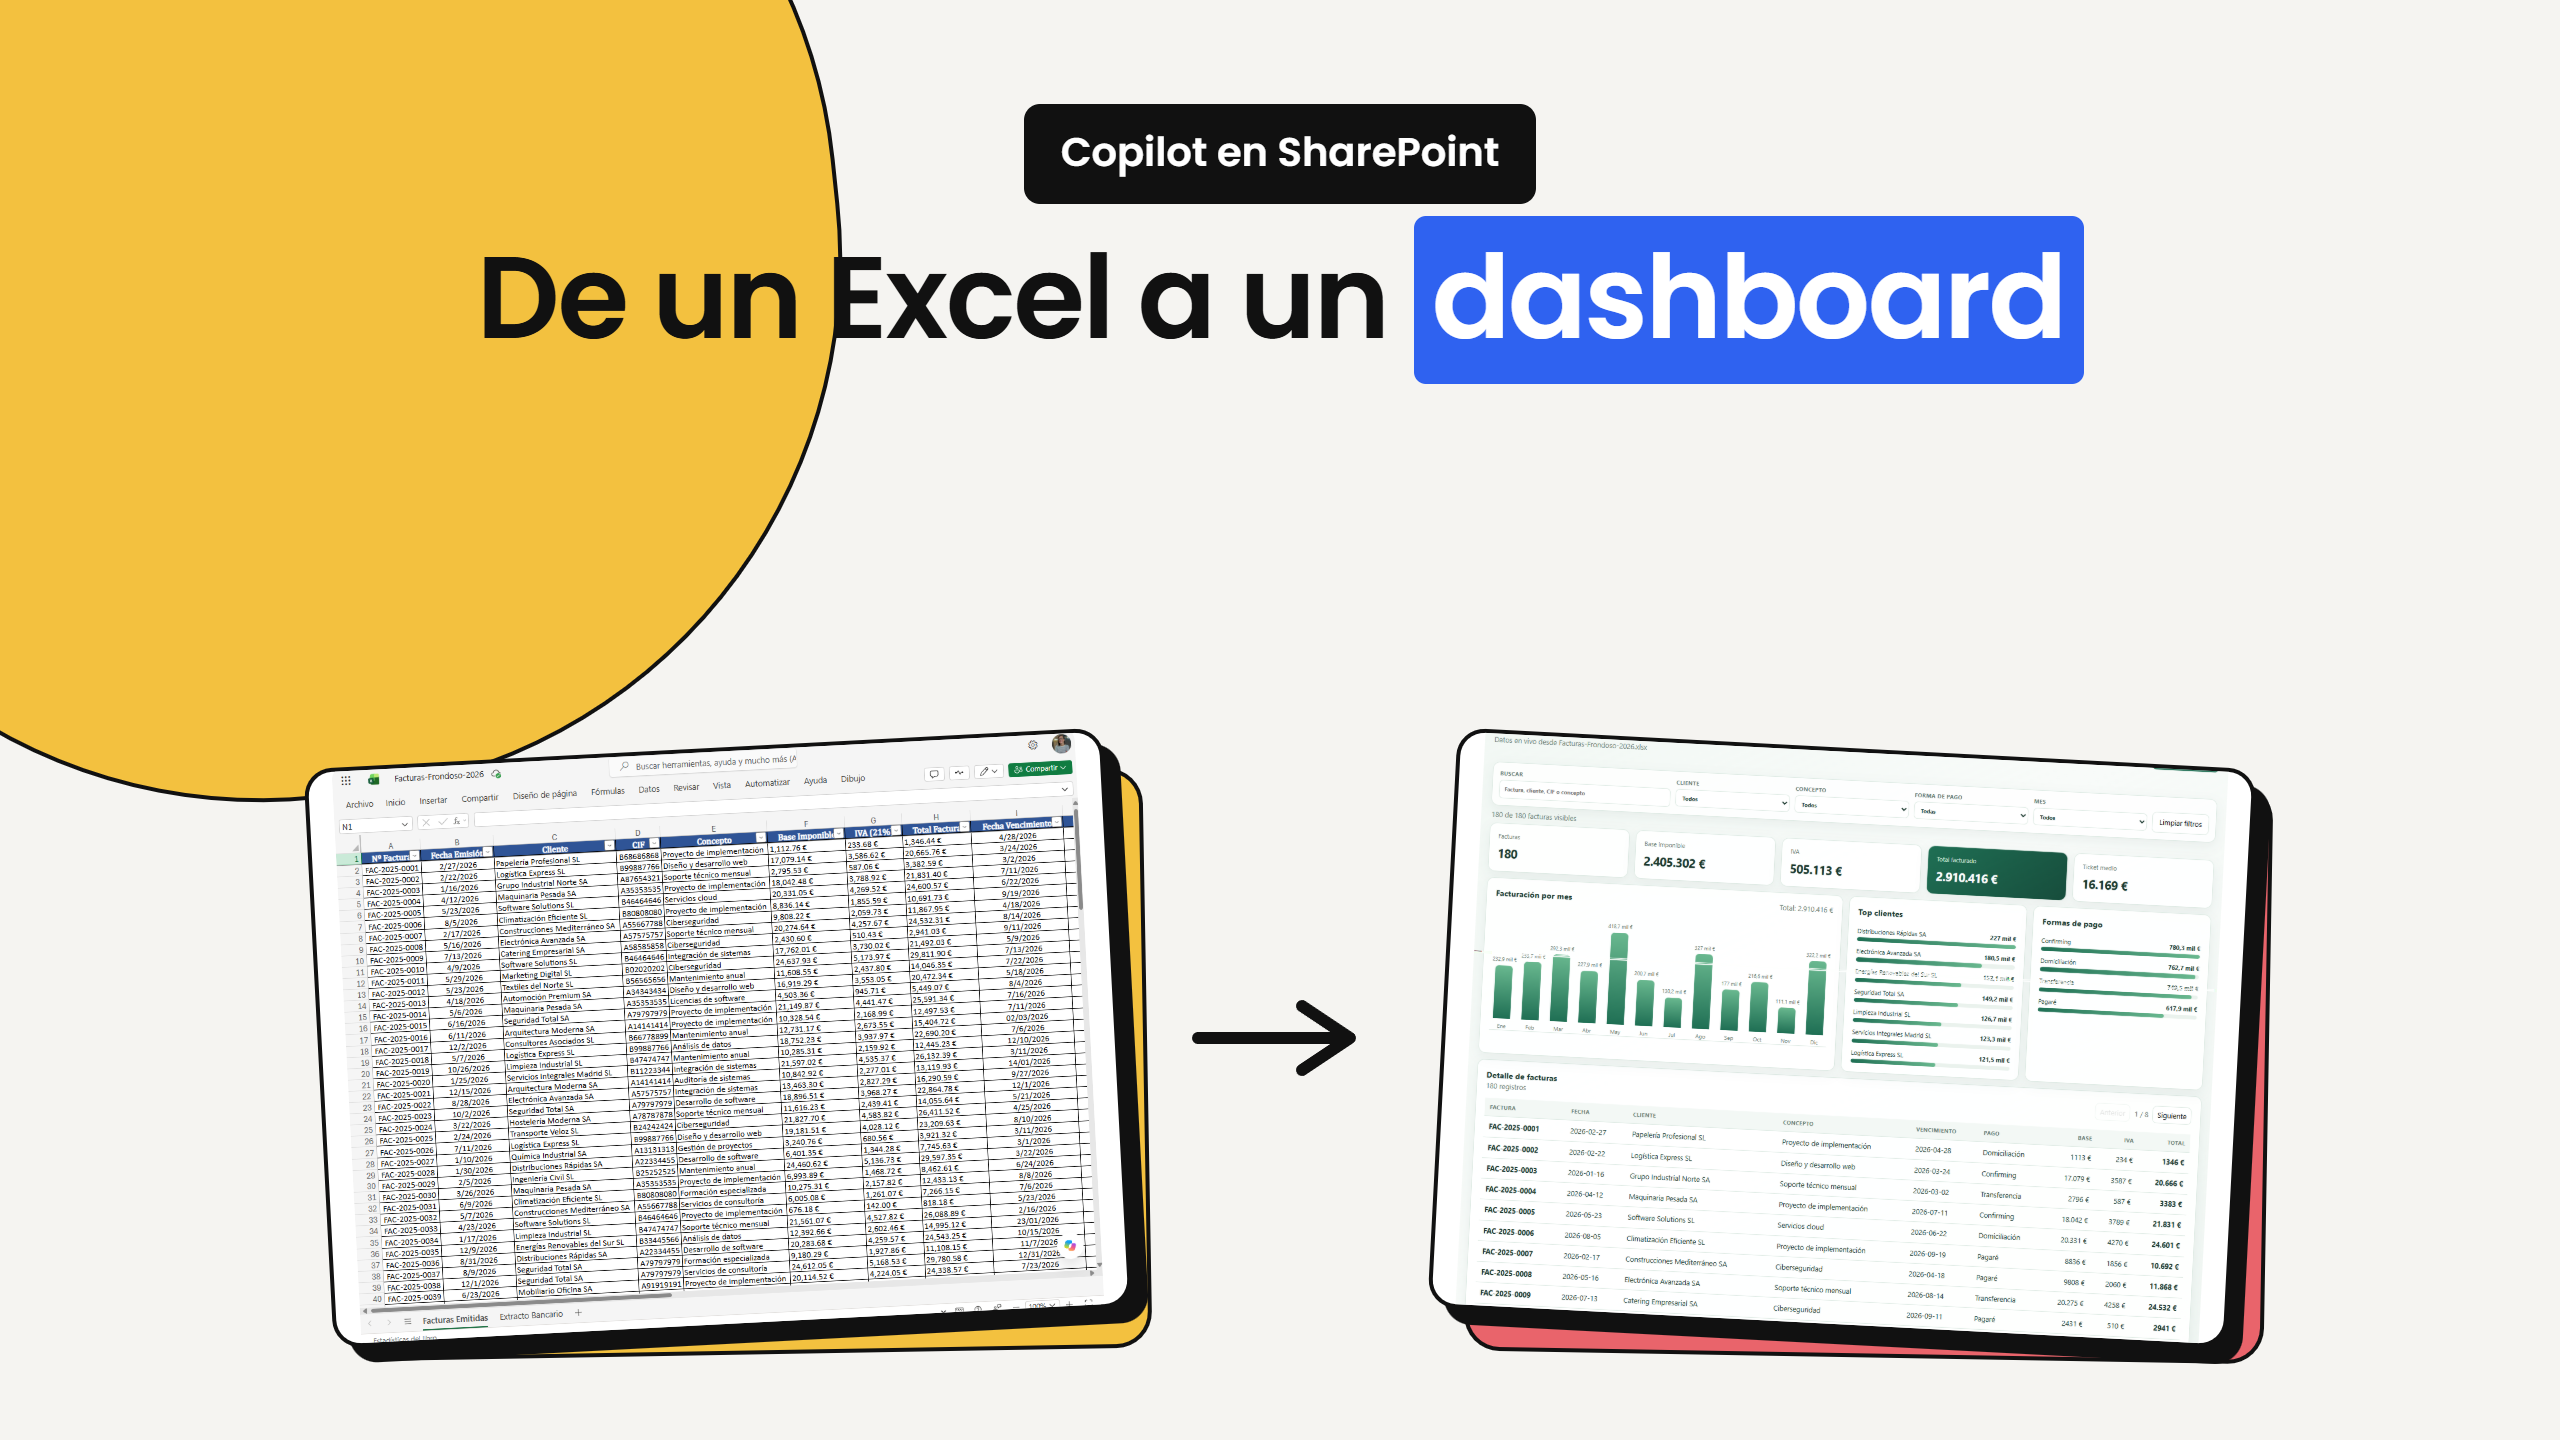
¿Cuánto puede variar el coste entre dos modelos cuando les pedimos resolver la misma tarea? Para comprobarlo, probé Opus 4.8 y Opus 5 en Copilot Cowork con un caso financiero basado en un Excel: analizar los datos de H1, proyectar H2 y construir un dashboard interactivo.
La prueba me ha dejado una conclusión interesante, y también una advertencia importante: comparar modelos no consiste únicamente en reutilizar un prompt. La IA no es determinista y puede elegir estrategias, herramientas y niveles de profundidad distintos.
Contexto: el lanzamiento de Claude Opus 5
Anthropic presentó oficialmente Claude Opus 5 el 24 de julio de 2026. La compañía lo posiciona como una mejora importante de la gama Opus para agentes de larga duración, programación y trabajo profesional, con mayor eficiencia y una capacidad reforzada para verificar su propio trabajo e iterar hasta completar tareas complejas.
Anthropic afirma que ofrece un rendimiento muy superior al de su predecesor para un coste equivalente y que permite ajustar el nivel de esfuerzo para equilibrar capacidad, velocidad y consumo.
Y el mismo día del anuncio, se anunció la incorporación de Claude Opus 5 a Microsoft 365 Copilot. El despliegue incluye expresamente Copilot Cowork, además de Word, Excel, PowerPoint, Copilot Chat y Copilot Studio.
La incorporación forma parte de la estrategia de elección de modelos de Microsoft 365 Copilot. Opus 5 se está desplegando en el selector de modelos, de modo que puede elegirse para trabajos que requieren razonamiento prolongado, análisis de varias etapas y elaboración de entregables completos.
Y el caso que he utilizado para la prueba reúne precisamente las características para las que Microsoft presenta Opus 5 en Copilot Cowork: una tarea larga, con análisis de un archivo, uso de varias herramientas y generación de distintos entregables. Por eso, comparar su consumo con Opus 4.8 permite observar cómo se comporta esta nueva opción dentro de un escenario real.
Comparando Opus 4.8 y Opus 5 en Copilot Cowork
Estos son los modelos disponibles hoy en Cowork:

Así que me he ido a Copilot Cowork y he ejecutado el mismo caso, con Opus 4.8 y con Opus 5 para observar las diferencias de consumo y entregables.
Nota: Aunque utilicemos la misma instrucción y los mismos datos de entrada, cada ejecución puede tomar un camino diferente. Por eso, la comparación solo resulta útil si controlamos no solo el prompt, sino también el alcance, los entregables y el nivel de calidad obtenido.
El prompt de partida
La petición inicial fue la siguiente:
Analiza el Excel adjunto y crea una previsión financiera para H2, de julio a diciembre.

Usa los datos reales disponibles de H1 y detecta automáticamente el año, los meses, las hojas y las cuentas contables.

Antes de calcular:

- Comprueba si los datos son mensuales o acumulados.
- Convierte los acumulados en importes mensuales cuando sea necesario.
- No utilices celdas con errores.
- Identifica gastos extraordinarios y no los proyectes como recurrentes.
- Utiliza la contabilidad como fuente principal si hay diferencias entre hojas.

Genera:

1. Análisis resumido de H1.
2. Previsión mensual de ventas, margen, gastos, EBITDA y resultado para julio-diciembre.
3. Previsión de cierre anual: H1 real + H2 previsto.
4. Previsión básica de caja.
5. Escenarios Base, Favorable y Adverso.
6. Principales hipótesis, riesgos y oportunidades.

Crea una dashboard interactivo en HTML con estas secciones:

- Datos normalizados.
- Hipótesis.
- Forecast H2.
- Cierre anual.
- Caja.
- Escenarios.
- Dashboard.

Utiliza fórmulas, documenta las hipótesis y comprueba que todas las cifras cuadran.
Primera ejecución y consumo observado
Ejecuté la tarea con Opus 4.8 y con Opus 5 y le pido el consumo imputado al finalizar. El resultado registrado fue este:


En Opus 5, el consumo mostrado al terminar la primera tarea fue de 0,2 créditos.
En Opus 4.8, el consumo mostrado fue de 615,2 créditos.
¿Qué estaba comparando?
Al revisar los resultados, detecté una diferencia relevante: Opus 4.8 había generado un entregable adicional que no aparecía explícitamente en la petición inicial, un modelo en Excel. Por tanto, la comparación directa de consumo todavía no era equivalente.

Así que para igualar el alcance, continué el mismo hilo con Opus 5 y solicité también ese archivo. El prompt adicional fue:
Crea también el mismo modelo en Excel con fórmulas nativas auditables para que pueda trazar y modificar cada celda.Y después de generar el Excel, revisé de nuevo el consumo total de Opus 5 para comparar ambos modelos con un conjunto de entregables más parecido.

Así que para el mismo entregable:
En Opus 5, el consumo total fue de 4,2 créditos.
En Opus 4.8, el consumo total fue de 615,2 créditos.
Qué se puede concluir de esta prueba
Pues creo que la diferencia es suficientemente grande como para justificar una revisión de qué modelo utilizar en tareas largas, con análisis de archivos y generación de varios entregables.
Sin embargo, piensa no es únicamente el número de créditos. También conviene valorar si ambos resultados:
Cubren exactamente los mismos requisitos.
Utilizan fórmulas auditables y cifras consistentes.
Excluyen correctamente errores y gastos extraordinarios.
Ofrecen un nivel comparable de detalle, diseño y usabilidad.
Necesitan el mismo número de correcciones o prompts adicionales.
Aprendizajes para comparar modelos
1️⃣Definir entregables cerrados. Hay que enumerar archivos, formatos, secciones y criterios de aceptación.
2️⃣Separar calidad y coste. Un modelo más barato no aporta más valor si requiere mucha revisión manual.
3️⃣Registrar la ejecución completa. Deben incluirse los prompts adicionales, los reintentos y las correcciones.
4️⃣Repetir la prueba. Una sola ejecución ilustra un caso, pero no permite generalizar.
5️⃣Medir el resultado final. El indicador relevante es el coste de obtener un entregable válido, no solo el de lanzar el primer prompt.
Conclusión
Mi prueba apunta a que Opus 5 puede ofrecer una ventaja de eficiencia muy significativa para este tipo de carga de trabajo. Aun así, la conclusión debe leerse como una observación práctica y no como un benchmark definitivo.
Me queda compararlo con GPT 5.6 con las dos versiones Sol y Terra.
La lección principal: para comparar modelos de forma útil, hay que controlar el alcance, igualar los entregables y medir tanto el consumo como la calidad final.
¡Espero que te sirva!


Deja una respuesta